Talking-Head-Material hochladen
Importiere deine aufgenommenen Talking-Head-Aufnahmen in gängigen Formaten; lange Clips werden in automatischen Segmenten verarbeitet. Frontale Gesichtsaufnahmen oder Halbnahe-Einstellungen funktionieren am besten.
Fehler und Stille automatisch entfernen, mit einem Klick vom Rohmaterial zum fertigen Video
Lade dein Talking-Head-Material hoch und die KI erkennt und entfernt automatisch Versprecher, Füllwörter und lange Pausen, während Audio und Video synchron bleiben — ein Grobschnitt von 30 Minuten Material ist in Minuten fertig. Gebaut für Wissenscreators, Kursdozenten und Creator vor der Kamera.
AIMIX herunterladenEine Stunde Talking-Head-Dreh bedeutet meist zwei Stunden Schnitt: Versprecher trimmen, Stille herausschneiden, Untertitel ergänzen — alles mechanische Arbeit. Der KI-Talking-Head-Editor verdichtet diesen Workflow in einen einzigen Durchgang: Die KI analysiert das Transkript Satz für Satz und markiert Fehler, Wiederholungen, Füllwörter und überlange Pausen. Du bestätigst jeden Punkt und löschst mit einem Klick; Video und Audio ziehen sich synchron zusammen und der Grobschnitt steht.
Importiere deine aufgenommenen Talking-Head-Aufnahmen in gängigen Formaten; lange Clips werden in automatischen Segmenten verarbeitet. Frontale Gesichtsaufnahmen oder Halbnahe-Einstellungen funktionieren am besten.
Die KI transkribiert und analysiert Zeile für Zeile: Versprecher und neu begonnene Sätze, Füllwörter (ähm, also, sozusagen) und stille Pausen jenseits des Schwellenwerts werden markiert und auf der Timeline hervorgehoben.
Hake jedes zu entfernende Segment ab — lösche ganze Sätze oder feinjustiere die Grenzen. Nach der Bestätigung werden Audio und Video synchron gelöscht und das Tempo zieht sich automatisch zusammen; der Grobschnitt fließt direkt in die Feinarbeit.
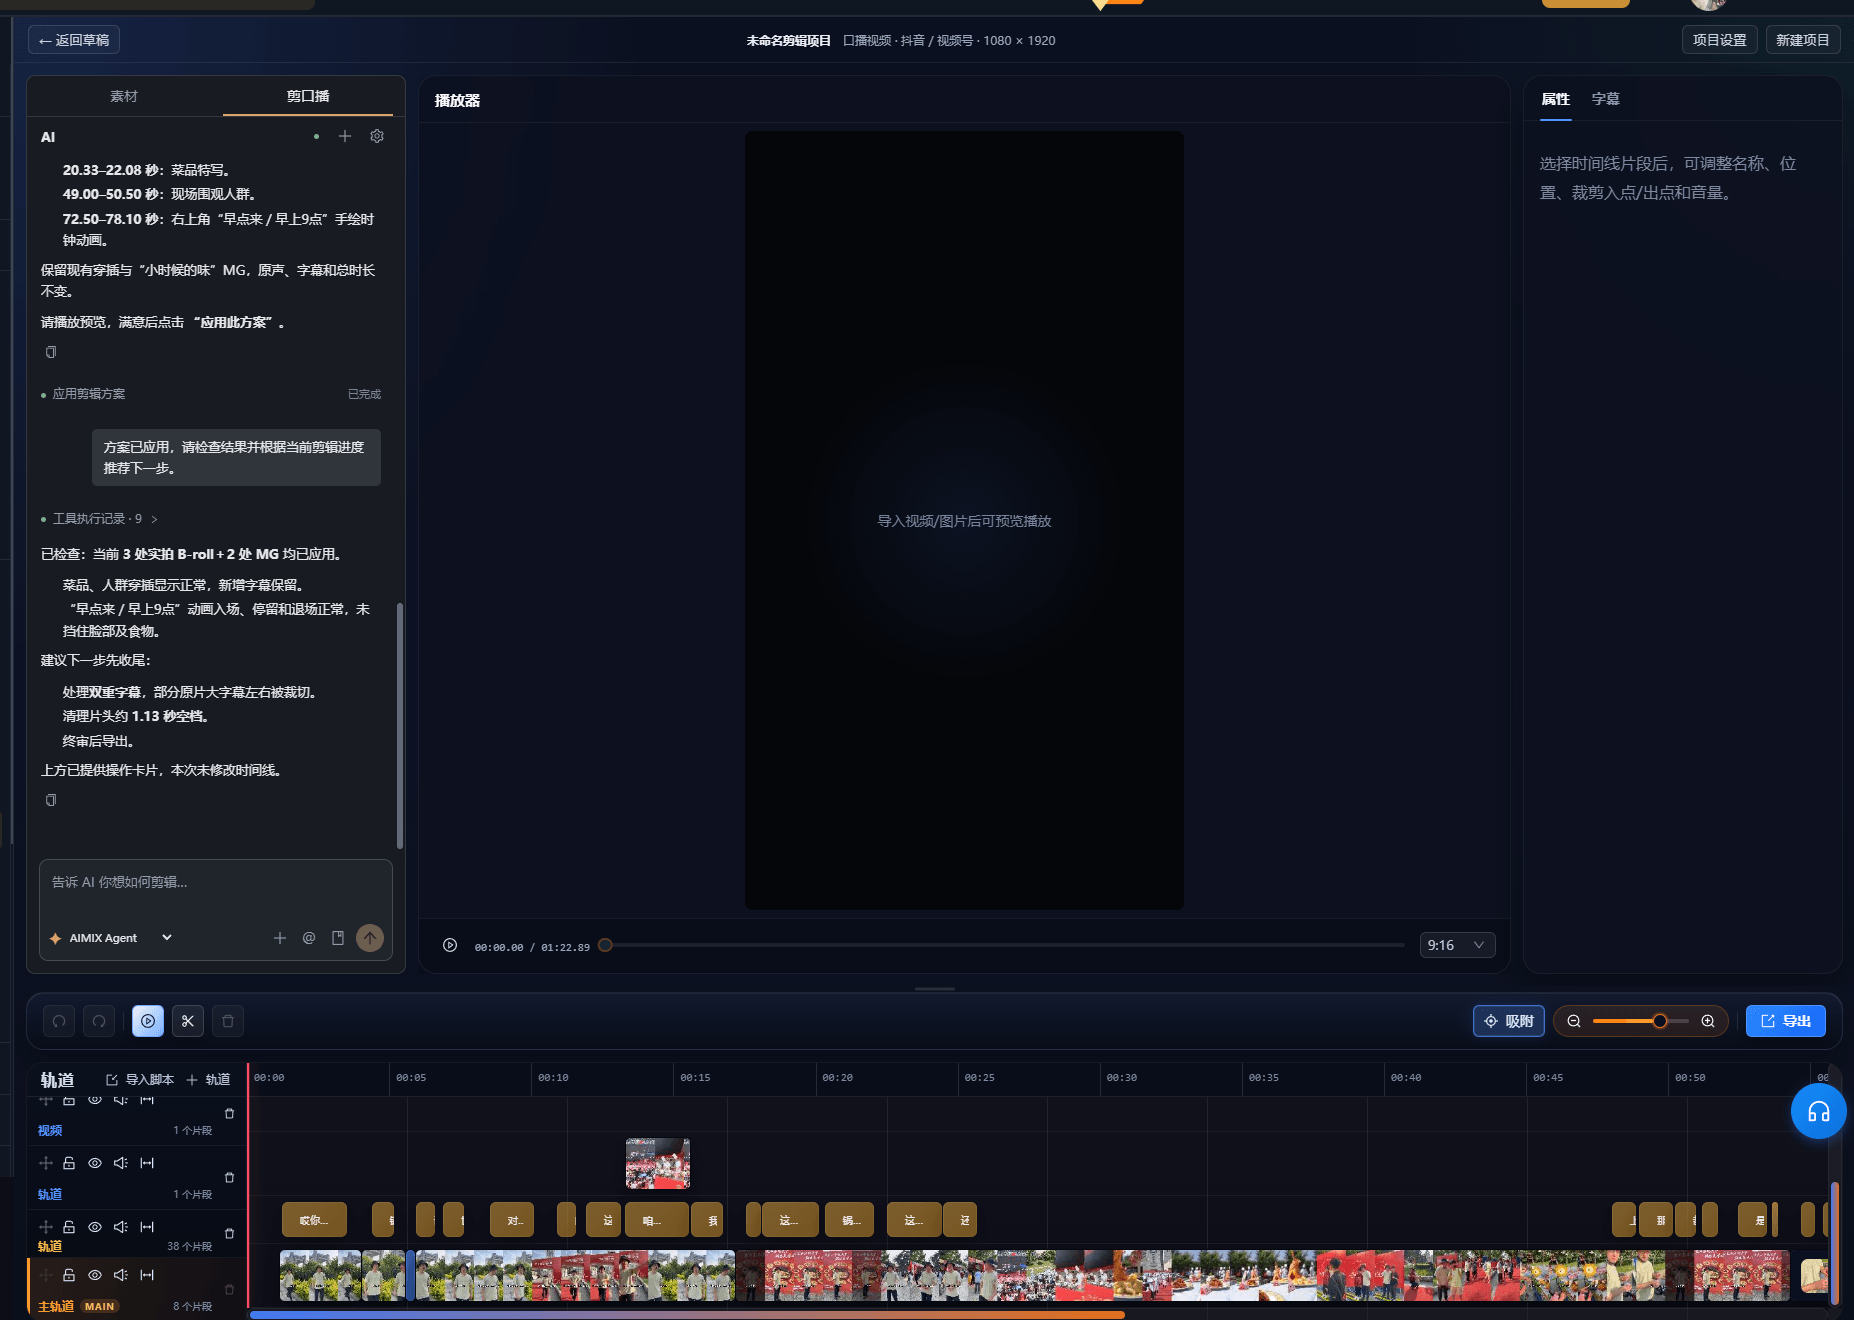
Die folgenden Fälle sind echte, unveränderte Anwendungsaufzeichnungen dieser Funktion in der AIMIX-App.
Am besten für: bildungsorientierte Talking Heads, Kursaufzeichnungen, Meinungscontent · häufige Updates vor der Kamera
结构Workflow: Material hochladen → KI markiert → einzeln bestätigen → mit einem Klick löschen → Untertitel ergänzen und exportieren
Talking-Head-Creator sollten ihre Zeit in den Content stecken, nicht in das frameweise Abtasten der Timeline. Die KI übernimmt den mechanischen Teil; der Mensch gibt nur noch das finale Okay.
Erkennungen werden nach Typ gruppiert, sodass du sie batchweise verarbeiten kannst:
Sätze, die verrutscht oder neu angesetzt wurden — standardmäßig wird die Löschung vorgeschlagen, wobei die letzte Aufnahme bleibt.
Ähm, also, sozusagen, weißt du — nach Dichte gesammelt löschen oder einige für ein Gesprächsgefühl behalten.
Pausen über dem eingestellten Schwellenwert ziehen sich automatisch zusammen; Denkpausen lassen sich manuell behalten.
Passagen, die dasselbe zweimal sagen — markiert, und du wählst, welche Version bleibt.
Jede Löschung geht durch dich: Die KI markiert und schlägt nur vor; sie rührt dein Material nie eigenmächtig an.
Nimm 30 Minuten Talking-Head-Material als Beispiel:
| Phase | Manueller Schnitt | KI-Talking-Head-Schnitt |
|---|---|---|
| Versprecher und Stille schneiden | 60-120 Minuten Frame-Arbeit | KI markiert in Minuten, nach Bestätigung Ein-Klick-Löschung |
| Audio-Video-Synchronität | Jeden Schnitt auf Framesprünge prüfen | Algorithmische Synchronität, Schnittpunkte richten sich automatisch aus |
| Tempokontrolle | Pausen nach Gefühl setzen | Einstellbarer Stille-Schwellenwert, Denkpausen bleiben behaltbar |
| Nacharbeitskosten | Falsche Schnitte bedeuten zurückspulen und neu schneiden | Markierungsliste überprüfbar, versehentliche Löschungen wiederherstellbar |
Die Feinarbeit (Tempo, Emotion, Texteffekte) passiert weiterhin auf der Timeline — die KI übernimmt die Fleißarbeit.
Die Erkennungsgenauigkeit hängt direkt von der Materialqualität ab — drei Dinge beim Drehen beachten:
Nutze ein Ansteckmikrofon oder nimm aus der Nähe auf; starker Umgebungslärm senkt die Transkriptionsgenauigkeit und erhöht die Markierungen.
Stoppe die Kamera nicht — sage einfach den kompletten Satz noch einmal, dann kann die KI leichter erkennen, welche Aufnahme bleiben soll.
Helle Sprünge schaden der Gesichtsverarbeitung; feste Ausleuchtung ist am zuverlässigsten.
Je sauberer dein Material, desto schneller der Bestätigungsschritt — und desto leichter deine tägliche Upload-Last.
Versprecher und Stille aus 30 Minuten Material zu entfernen sinkt von Stunden auf Minuten.
Schnittpunkte werden algorithmisch ausgerichtet und beseitigen das visuelle Stottern, das Talking-Head-Creator am meisten fürchten.
Die KI markiert, löscht aber nie von selbst — du entscheidest immer, was bleibt.
Nach dem Grobschnitt Untertitel ergänzen oder Voiceovers mit einem Klick tauschen — der gesamte Workflow bleibt in AIMIX.
Bei sauberem Ton ist die Genauigkeit hoch; laute Umgebungen erzeugen mehr Markierungen, und der Punkt-für-Punkt-Bestätigungsworkflow garantiert, dass nichts versehentlich gelöscht wird.
Es folgen die derzeit von der Desktop-App unterstützten Transkriptionssprachen; chinesische und englische Talking Heads funktionieren am besten.
Die Markierungsliste führt eine Operationshistorie, und jedes Segment lässt sich vor der Bestätigung wiederherstellen; jede vor dem Export vorgenommene Löschung ist umkehrbar.
Ja — die Kernabhängigkeit ist die Audio-Transkription. Material mit Gesicht wird besser verarbeitet, aber Versprecher und Stille lassen sich auch ohne dein Gesicht im Bild entfernen.
Der Stille-Schwellenwert ist einstellbar, und du kannst Denkpausen manuell behalten, um zu steuern, wie das fertige Video atmet.
Ja — verarbeite mehrere Talking-Head-Clips hintereinander und kombiniere mit dem Batch-Export für tägliche Uploads und Kursproduktion.
Das hängt von der Materiallänge ab; typische Talking-Head-Clips werden in wenigen Minuten markiert.
Nein — die gesamte Verarbeitung passiert innerhalb des Projekts, und deine Originaldateien bleiben unangetastet.