ارفع لقطة المتحدث
استورد لقطات المتحدث المسجلة بصيغ شائعة؛ وتُعالج المقاطع الطويلة في أجزاء تلقائية. طلقات الوجه الأمامية أو التأطير حتى الخصر تعطي أفضل النتائج.
إزالة تلقائية للأخطاء والصمت، وبنقرة واحدة من اللقطة الخام إلى الفيديو النهائي
ارفع لقطة المتحدث الخاصة بك وسيكتشف الذكاء الاصطناعي تلقائيًا الهفوات وحشوات الكلام والإيقافات الطويلة ويزيلها مع الحفاظ على تزامن الصوت والصورة — مونتاج أولي لثلاثين دقيقة من اللقطات يكتمل في دقائق. مصمَّم لصنّاع المحتوى المعرفي ومدرّبي الدورات وصنّاع المحتوى أمام الكاميرا.
تنزيل AIMIXساعة واحدة من تصوير مقاطع المتحدث تعني عادة ساعتين من المونتاج: تقليم الهفوات، وقطع الصمت، وإضافة الترجمات — عمل ميكانيكي بالكامل. يحوّل محرر مقاطع المتحدث بالذكاء الاصطناعي هذا السير العمل إلى جولة واحدة: يحلل الذكاء الاصطناعي النص المفرّغ جملة جملة ويؤشر الأخطاء والتكرارات وحشوات الكلمات والإيقافات الطويلة جدًا. أنت تؤكد كل عنصر وتحذفه بنقرة واحدة؛ فينضغط الفيديو والصوت بتزامن، وينتهي المونتاج الأولي.
استورد لقطات المتحدث المسجلة بصيغ شائعة؛ وتُعالج المقاطع الطويلة في أجزاء تلقائية. طلقات الوجه الأمامية أو التأطير حتى الخصر تعطي أفضل النتائج.
يفرّغ الذكاء الاصطناعي النص ويحلله سطرًا سطرًا: الهفوات والجمل المعاد نطقها وحشوات الكلام (إم، إيه، أتعلم) والإيقافات الصامتة التي تتجاوز الحد — كلها مؤشرة ومميزة على الخط الزمني.
علّم كل مقطع تريد إزالته — احذف جملًا كاملة أو اضبط الحدود بدقة. بعد التأكيد تُحذف الملفات الصوتية والمرئية بتزامن وينضغط الإيقاع تلقائيًا؛ وينتقل المونتاج الأولي مباشرة إلى الضبط الدقيق.
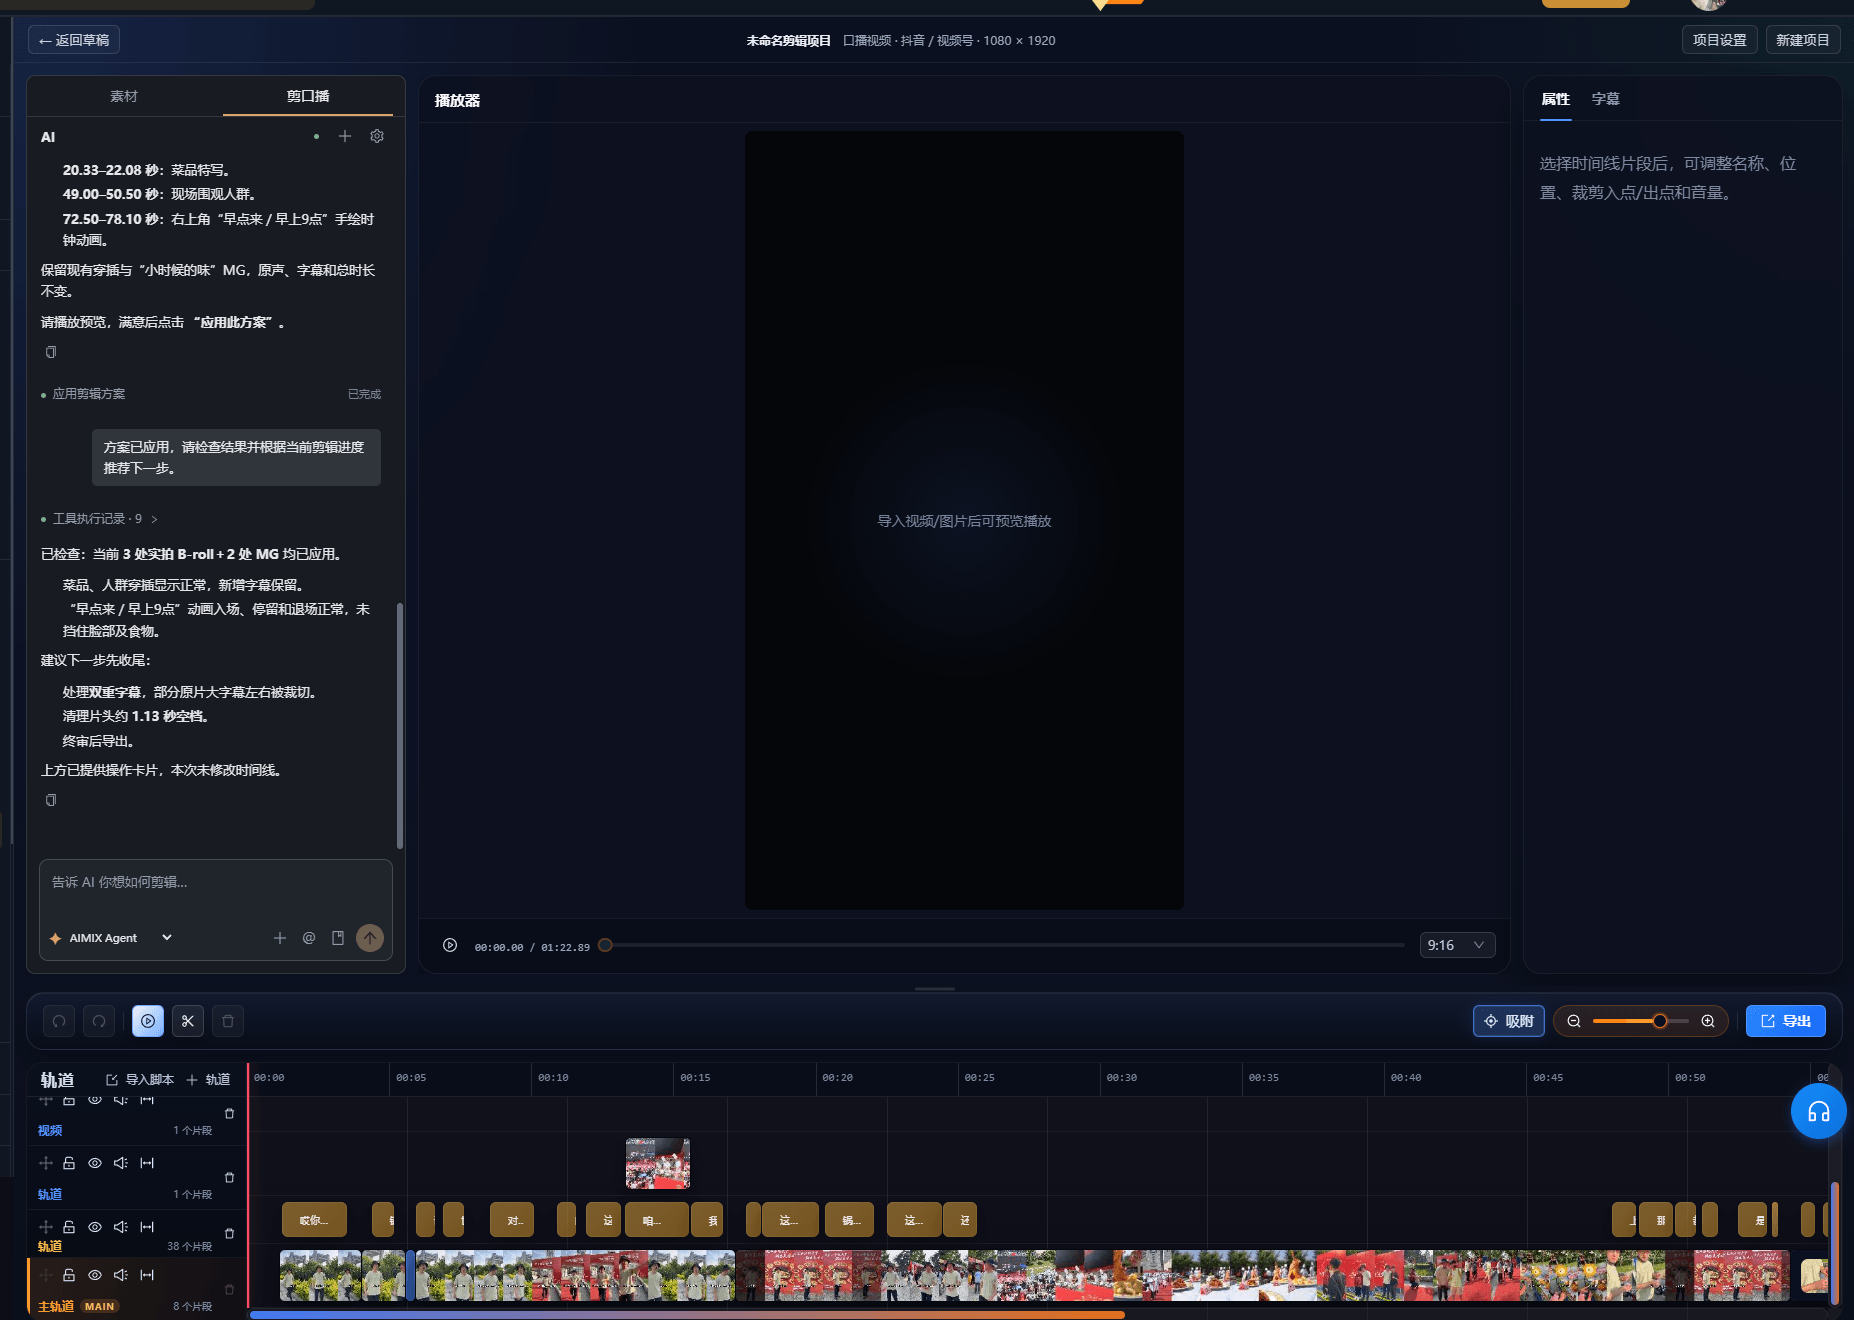
الحالات التالية سجلات استخدام حقيقية لهذه الميزة في تطبيق AIMIX دون تعديل.
الأنسب لـ: مقاطع المتحدث التعليمية، تسجيلات الدورات، محتوى الآراء · ظهور متكرر أمام الكاميرا
结构سير العمل: رفع اللقطة ← الذكاء الاصطناعي يؤشر ← التأكيد واحدًا واحدًا ← حذف بنقرة ← إضافة ترجمات وتصدير
ينبغي لصنّاع مقاطع المتحدث قضاء وقتهم في المحتوى لا في تقليب الخط الزمني إطارًا بإطار. الذكاء الاصطناعي يتولى الجزء الميكانيكي؛ والإنسان يمنح الموافقة النهائية فحسب.
تُجمَّع الاكتشافات حسب النوع، فيمكنك معالجتها دفعات:
جمل نُطقت خطأً أو أُعيدت من البداية — يُقترح حذفها افتراضيًا مع الاحتفاظ بالنطق الأخير.
إم، إيه، يعني، أتعلم — احذفها دفعات حسب الكثافة أو أبقِ بعضها لمذاق حواري طبيعي.
الإيقافات التي تتجاوز الحد المحدد تنضغط تلقائيًا؛ ويمكن الإبقاء يدويًا على إيقافات التفكير.
مقاطع تقول الشيء نفسه مرتين — مؤشرة، وتختار أنت أي نسخة تبقيها.
كل حذف يمر عبرك: الذكاء الاصطناعي يؤشر ويقترح فقط؛ ولا يلمس لقطاتك من تلقاء نفسه أبدًا.
خذ ثلاثين دقيقة من لقطة متحدث كمثال:
| المرحلة | المونتاج اليدوي | مونتاج المتحدث بالذكاء الاصطناعي |
|---|---|---|
| قطع الهفوات والصمتات | 60-120 دقيقة من التقليب | الذكاء الاصطناعي يؤشر في دقائق وحذف بنقرة بعد التأكيد |
| تزامن الصوت والصورة | فحص كل قطع بحثًا عن قفزات الإطارات | تزامن خوارزمي ونقاط قطع تتطابق تلقائيًا |
| التحكم في الإيقاع | وضع الإيقاف بالحدس | حد صمت قابل للضبط مع إمكانية الإبقاء على إيقافات التفكير |
| تكلفة الإعادة | القطوع الخاطئة تعني التراجع وإعادة المونتاج | قائمة تأشير قابلة للمراجعة وحذوفات عرضية قابلة للاستعادة |
الضبط الدقيق (الإيقاع والعاطفة وتأثيرات النص) يظل على الخط الزمني — الذكاء الاصطناعي يتولى العمل الشاق.
تعتمد دقة الاكتشاف مباشرة على جودة اللقطات — ثلاثة أمور انتبه لها أثناء التصوير:
استخدم ميكروفون ياقة أو سجّل عن قرب؛ الضجيج المحيطي الكثيف يخفض دقة التفريغ النصي ويزيد التأشيرات.
لا توقف الكاميرا — انطق الجملة كاملة مرة أخرى فقط، فيستطيع الذكاء الاصطناعي تمييز النطق الذي يجب الاحتفاظ به بسهولة أكبر.
التغيرات الحادة في السطوع تضر بمعالجة الوجه؛ والإضاءة الثابتة هي الأكثر موثوقية.
كلما كانت لقطاتك أنظف، تسارعت خطوة التأكيد — وخفّت عبء نشرتك اليومية.
إزالة الهفوات والصمتات من ثلاثين دقيقة من اللقطات تهبط من ساعات إلى دقائق.
تُحاذى نقاط القطع خوارزميًا، ما يلغي التلعثم البصري الذي يخشاه صنّاع مقاطع المتحدث أكثر من غيره.
الذكاء الاصطناعي يؤشر لكنه لا يحذف من تلقاء نفسه أبدًا — القرار النهائي لك دائمًا فيما يبقى.
بعد المونتاج الأولي أضف ترجمات أو بدّل التعليقات الصوتية بنقرة واحدة — يبقى سير العمل كله داخل AIMIX.
الدقة عالية مع الصوت النظيف؛ البيئات الصاخبة تنتج تأشيرات أكثر، وسير عمل تأكيد كل عنصر يضمن ألا يُحذف شيء خطأً.
يتبع لغات التفريغ الصوتي التي تدعمها نسخة سطح المكتب حاليًا؛ ومقاطع المتحدث بالصينية والإنجليزية تعمل بشكل أفضل.
تحتفظ قائمة التأشير بسجل العمليات، ويمكن استعادة أي مقطع قبل التأكيد؛ وكل حذف يتم قبل التصدير قابل للتراجع.
نعم — الاعتماد الأساسي على تفريغ الصوت. اللقطات التي يظهر فيها الوجه تُعالج بشكل أفضل، لكن يمكن إزالة الهفوات والصمتات أيضًا دون ظهور وجهك في الكادر.
حد الصمت قابل للضبط، ويمكنك الإبقاء يدويًا على إيقافات التفكير للتحكم في نفَس الفيديو النهائي.
نعم — عالج عدة مقاطع متحدث الواحد تلو الآخر واقرنها بالتصدير الدفعي للنشر اليومي وإنتاج الدورات.
يعتمد على طول اللقطة؛ وتُؤشَّر مقاطع المتحدث النموذجية خلال دقائق.
لا — تتم كل المعالجة داخل المشروع، وتبقى ملفاتك الأصلية دون مساس.