上传口播素材
导入拍摄好的口播录像,支持常见格式;长素材自动分段处理,人脸出镜或半身画面效果最好。
自动删口误、去静音,口播视频一键成片
上传口播录像,AI 自动识别并删除口误、语气词与长停顿,保持音画同步,一条 30 分钟素材几分钟完成粗剪。适合知识博主、课程讲师与出镜创作者。
下载 AIMIX口播视频拍摄一小时,剪辑往往要两小时:掐口误、删静音、补字幕,全是机械劳动。AI 剪口播把这段流程压缩成一次识别——AI 按转写文本逐句分析,标记口误、重复、语气词和过长停顿,你逐条确认后一键删除,画面音轨同步收紧,粗剪直接完成。
导入拍摄好的口播录像,支持常见格式;长素材自动分段处理,人脸出镜或半身画面效果最好。
AI 转写并逐句分析:标记口误与说错重说的句子、语气词(嗯、啊、就是说)、超过阈值的静音停顿,在时间线上高亮列出。
逐条勾选要删的片段,支持整句删或微调边界;确认后音画同步删除,节奏自动收紧,粗剪版本直接进入精修流程。
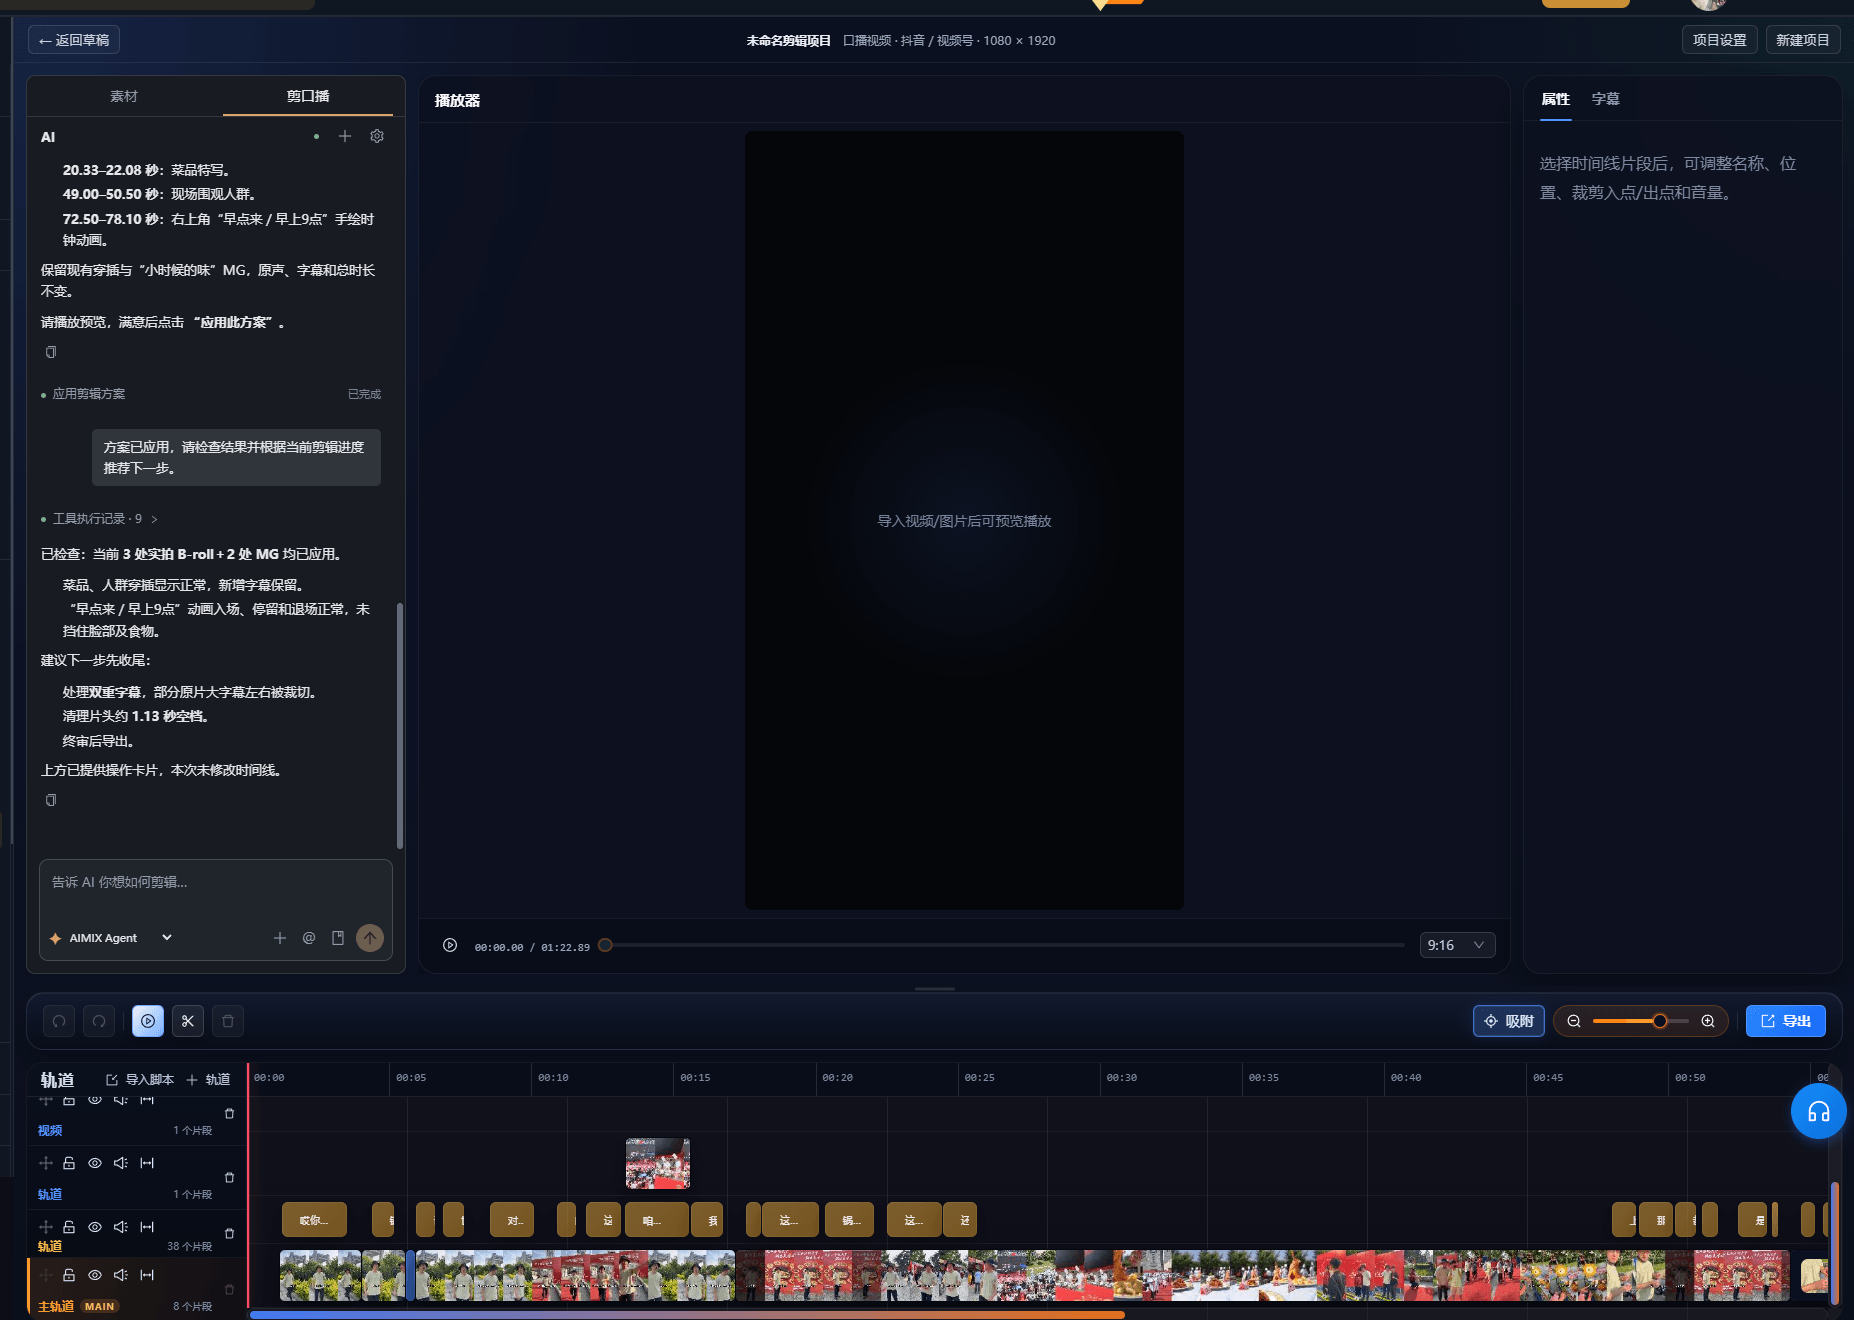
以下案例为 AIMIX 客户端中该功能的实际使用记录,数据未做删改。
适用类型:知识口播、课程录制、观点输出 · 高频出镜更新
结构流程:上传素材 → AI 标记 → 逐条确认 → 一键删除 → 加字幕出片
口播创作者的时间应该花在内容上,不是花在反复拉时间线掐帧上。AI 处理机械部分,人只做最终确认。
识别结果按类型分组,你可以按类批量处理:
说错、卡壳后重新表述的整句,默认建议删除,保留最终说法。
嗯、啊、这个、就是说等填充词,可按密度策略批量删或保留少量口语感。
超过设定阈值的停顿自动收紧,思考型停顿可手动保留。
同一意思说了两遍的段落,标记后由你选择保留哪一版。
所有删除都经你确认,AI 只做标记与建议,不擅动素材。
以一条 30 分钟口播素材为例:
| 环节 | 手动剪辑 | AI 剪口播 |
|---|---|---|
| 掐口误静音 | 60-120 分钟逐段拉片 | AI 几分钟标记,确认后一键删 |
| 音画同步 | 逐处检查跳帧 | 算法同步,删除点自动对齐 |
| 节奏控制 | 凭手感留停顿 | 静音阈值可调,思考停顿可保留 |
| 返工成本 | 删错需回退重剪 | 标记列表可回看,误删可恢复 |
精修环节(节奏、情绪、花字)仍在时间线完成,AI 负责的是体力活。
识别准确率与素材质量直接相关,拍的时候注意三点:
使用领夹麦或近距离收音,环境噪音大时转写准确率下降,标记会变多。
说错不要停机,直接把整句话重新说一遍,AI 更容易识别"保留哪一版"。
画面亮度剧烈变化会影响人脸相关的处理效果,固定光源最稳。
素材越规范,确认环节越快,日更压力就越小。
30 分钟素材的口误静音清理从小时级降到分钟级。
删除点按算法对齐,出口播视频最怕的画面跳动问题。
AI 只标记不擅删,重要表述永远由你决定去留。
粗剪完成后一键上字幕、配音替换,整条工作流不用出 AIMIX。
收音清晰的素材识别率较高;噪音大的环境标记会增多,逐条确认的机制保证不会误删。
以客户端当前支持的转写语言为准,中英文口播效果最好。
标记列表保留操作记录,可在确认前恢复任意片段;导出前的删除都可撤销。
可以,核心依赖是音频转写;出镜画面的处理效果更好,但不出镜同样能删口误与静音。
静音阈值可调,也可以手动保留思考型停顿,控制成片的呼吸感。
可以,多条口播素材依次处理,配合批量导出适合日更与课程制作。
取决于素材时长,常规口播素材几分钟内完成识别标记。
不会,所有处理在项目内进行,原始文件保持不变。